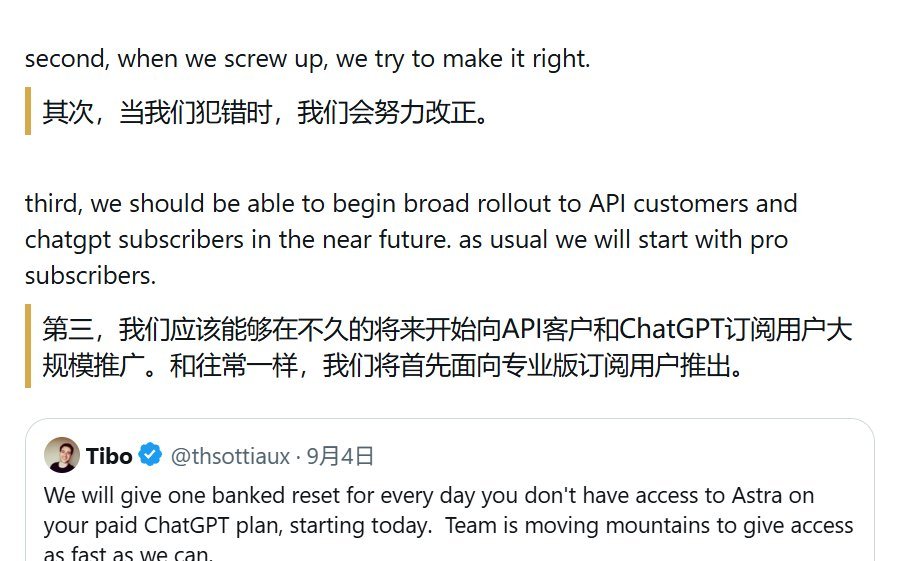
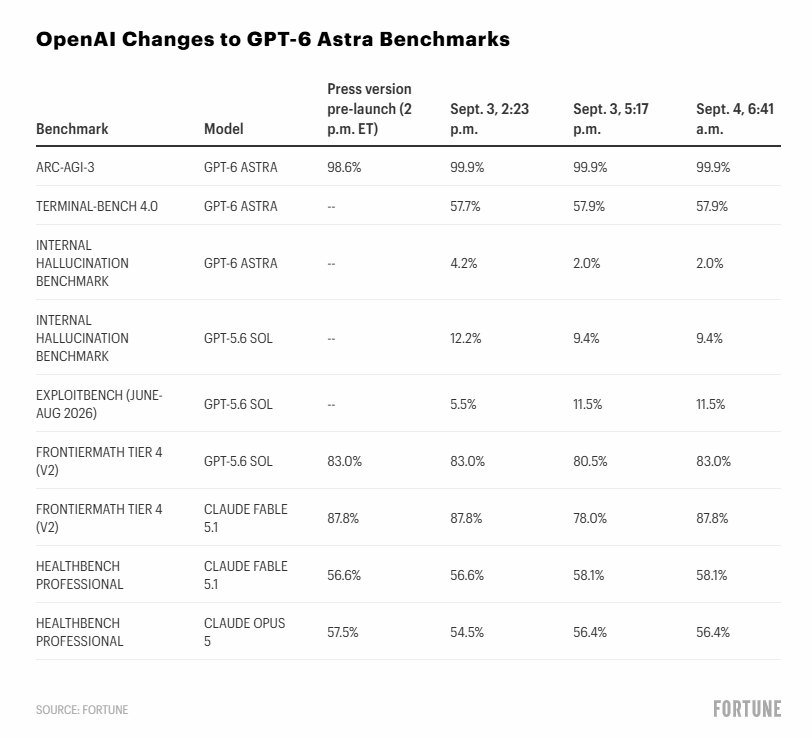
据 Fortune 报道、IT 之家转述,OpenAI 自 9 月 3 日发布 GPT-6 Astra 的公告以来,多次修改公告中的评测基准数据,部分成绩变化幅度不小——其中幻觉率一项曾从 4.2% 下调至 2%,随后又改了回去。
关键信息
- 生效时间:Astra 于 9 月 3 日发布,数据修改发生在发布后的几天内
- 影响谁:按厂商公布的评测指标做模型选型的人;把某个模型硬编码进自动化流程的团队
- 要不要动:不用换模型。把选型依据从厂商数据换成你自己的任务样本
发生了什么
被修改的是发布公告页上的基准测试数字,也就是模型发布当天被引用最多、传播最广的那部分内容。幻觉率从 4.2% 改到 2%、之后又改回,是报道点名的例子。截至目前,OpenAI 没有就修改原因给出公开说明。需要说明的是,本条来自媒体报道的转述,不是一手公告。
对独立站卖家意味着什么
这条事情本身不大,但它对应一个很多人正在踩的坑:拿发布会当天的跑分决定自己用什么模型。厂商公布的基准数据既可能事后修订,也天然是在对自己有利的设置下测出来的,跟你的实际任务——写产品描述、改 listing、处理客服工单、批量生成结构化数据——相关性很弱。跑分高一截的模型在你的具体活儿上更差,是常有的事。
更实际的做法是自己建一个小评测集:从过去真实做过的任务里挑 20–30 条,连同你认可的输出一起存起来。以后每次想换模型,就把这批跑一遍,人工看结果。这套东西做一次,之后每次选型都能复用,比追任何榜单都可靠,成本也就一个下午。
还有一点值得注意:如果你的自动化流程里写死了某个模型版本,厂商修订公开指标不影响你,但模型静默更新会。给关键流程留一个「输出突然变差时怎么发现」的检查点——比如定期抽查几条输出人工过一遍——比盯着谁家跑分高有用得多。