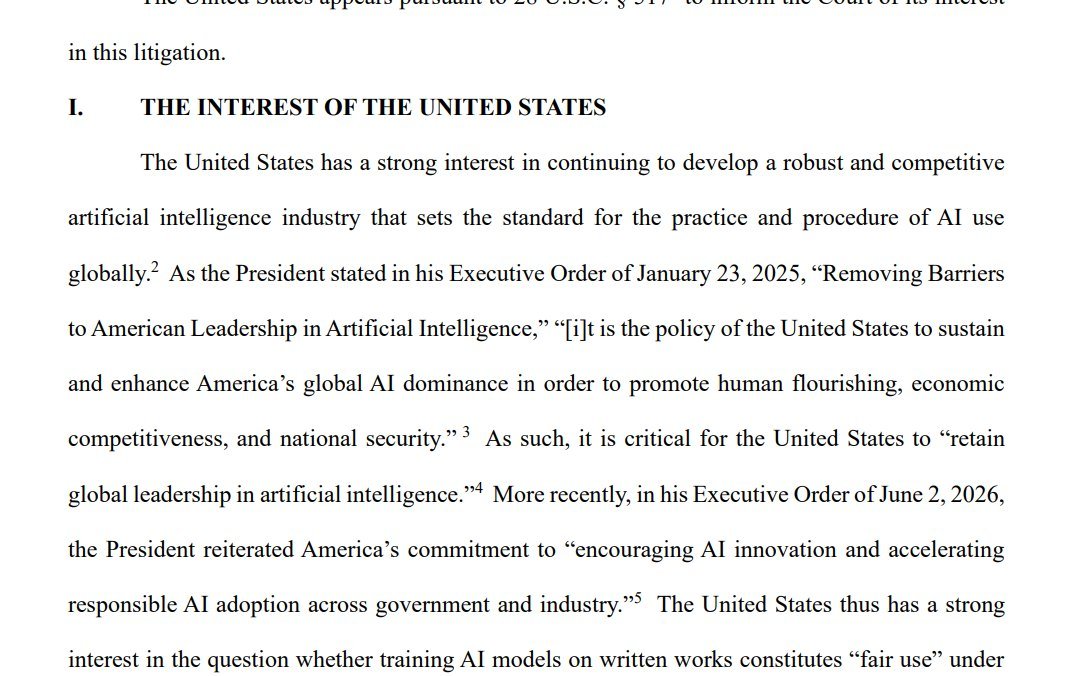
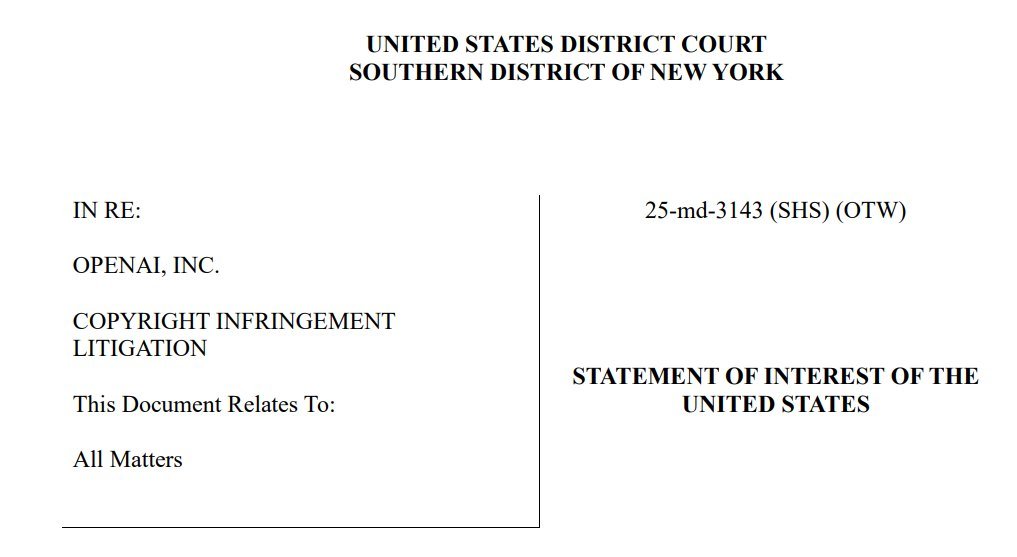
据 IT 之家报道,美国司法部于 9 月 1 日向曼哈顿联邦法院提交利益声明,介入《纽约时报》诉 OpenAI 版权案,支持大语言模型训练构成合理使用的主张。
关键信息
- 生效时间:司法部文件于 9 月 1 日提交;法官要求双方最迟 9 月 4 日提交简易判决动议
- 影响谁:以原创内容为核心资产的站点;以及依赖 AI 生成内容做规模化产出的团队
- 要不要动:暂时不用动,等简易判决结果;现在就该做的是让你的原创内容有清晰的作者、时间和实体标注
发生了什么
司法部在这份利益声明中以国家安全和美国 AI 产业竞争力为主要论据,称模型训练对受版权保护材料的使用具有转换性(transformative),因而属于合理使用。《纽约时报》发言人批评政府站在 AI 公司一边、牺牲创作者权益。法官已要求双方最迟在 9 月 4 日提交简易判决动议。该案的结果可能为 AI 训练使用版权材料的合法性确立先例。需要说明的是,利益声明本身不具约束力,法院是否采纳司法部的立场并不确定。
对独立站卖家意味着什么
短期没有任何要改的动作,长期方向值得记一笔。如果法院最终认定训练属于合理使用,你的产品描述、原创评测、拍摄的商品图被拿去训练模型这件事,就基本没有法律救济路径了——「屏蔽 AI 爬虫」会从一个可选的策略变成唯一的技术手段(这也是今天另一条关于 robots.txt 与 WAF 的新闻值得一起看的原因)。反过来如果法院支持《纽约时报》,则可能出现授权和付费机制,但对中小站点来说,能分到的谈判筹码依然接近于零。
无论哪个方向,中小内容站点的实际处境变化不大:你的内容会被用于训练,这是既定事实。真正能改善你处境的不是版权判决,而是让 AI 系统在引用时能识别出内容来自你——清晰的作者署名、发布时间、结构化数据里的组织和作者实体标注。这些工作现在做,不管官司怎么判都有用。别把精力花在追踪案件进展上,9 月 4 日之后大概率还有一轮又一轮。


